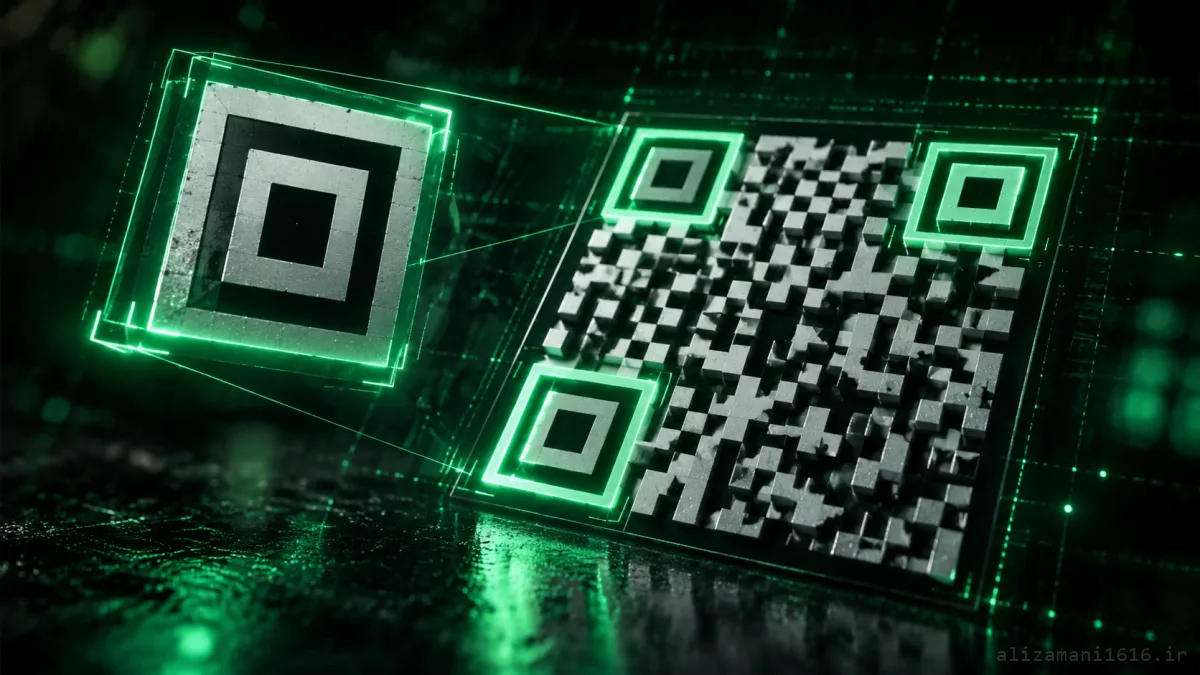
# جواب کوتاه: سه مربع، نقطهی شروع اسکناند
دوربین شما «کد» نمیبیند. یک عکس معمولی میبیند: میلیونها پیکسل، لبههای سیاه و سفید بیشمار — پردهی اتاق، موج روی مبل، حروف یک روزنامه، بافت چوب میز. از میان این همه سیاه و سفید، از کجا شروع کند؟ کجاها «داده» است و کجاها فقط دکور جهان واقعی؟
جواب، آن سه مربعاند. اسم رسمیشان الگوی یابنده — Finder Pattern است و سه کار میکنند که هیچکدام بدون دیگری ممکن نیست:
پیدا کردن — به دوربین میگویند «این نقطهچین سیاهوسفید یک QR است؛ نه بافت پیراهن، نه سایهی نرده».
جهت گرفتن — از روی گوشهی خالی میفهمند کدام سمت «بالا»ی کد است؛ چون QR را باید از یک سمت مشخص خواند.
مقیاس گرفتن — فاصلهی مربعها به اسکنر میگوید هر خانهی کوچک کد، در این عکس چند پیکسل است.
حالا ترتیب کامل کار اسکنر، از لحظهای که عکس میگیرد تا لحظهای که لینک باز میشود:
1
سه مربع را پیدا کن — دنبال امضای شکلِ «مربع داخل مربع» بگرد
2
از گوشهی خالی، جهت را بگیر — گوشهای که مربع ندارد، پایین-راست است
3
از خطکشهای نقطهچین، شبکه را بکش — حالا میدانی هر خانه کجاست
4
خانهبهخانه بخوان — سیاه و سفیدها دیگر «عکس» نیستند؛ بیتاند
یک تفاوت مهم همینجاست: دادههای داخل کد میتوانند لکه شوند، خش بیفتند، زیر فنجان بروند — اسکنر راهی برای جبرانشان دارد. اما آن سه مربع در هیچ سطحی جبرانپذیر نیستند؛ چون خودشان قبل از همهی جبرانها لازماند.
# چرا اصلاً اسکن اینقدر سخت است؟
برای اینکه معلوم شود این سه مربع چه مشکلی را حل میکنند، اول باید دید مشکل چیست. بارکد خطیِ پشت محصولات فروشگاه را با یک لیزر میخوانند: لیزر یک خط صاف را از عرض بارکد رد میکند و ضخامت خطوط سیاه را میشمارد. کارش آسان است چون بارکد یکبعدی است: فقط طولش معنا دارد، عرضش فرقی نمیکند. نتیجه؟ ظرفیت چند حرف، و خواندن فقط از یک جهت مشخص.
QR این محدودیتها را یکجا دور زد: بهجای خط، ماتریس؛ بهجای لیزر، دوربین؛ بهجای یک جهت، هر جهتی. اما این آزادی هزینه داشت: دوربین از هر فاصله و زاویهای عکس میگیرد، و در عکس، همهچیز شبیه همهچیز است. یک QR بدون مربعهای راهنما فقط انبوهی از لبههای سیاهوسفید است: داده هست، ولی معلوم نیست از کدام خانه باید شروع به خواندن کرد.
بارکد خطی
یکبعدی؛ خواندن با لیزر و از یک جهت؛ ظرفیت حدود ۱۳ رقم در استاندارد فروشگاهی (EAN-13)؛ تحمل خطا تقریباً صفر — یک خط خش، تمام
کد QR
دوبعدی؛ خواندن با دوربین از هر زاویه و فاصله؛ ظرفیت تا ۷٬۰۸۹ رقم در بزرگترین نسخه؛ تحمل خطای ۷ تا ۳۰ درصد با تصحیح خطا
# قصه: کارخانهی تویوتا و صفحهی گو
سال ۱۹۹۴، در کارخانههای شرکت Denso — زیرمجموعهای از گروه تویوتا در ژاپن — مهندسی به اسم ماساهیرو هارا یک مسئلهی ملالآور داشت: ردیابی قطعات خودرو. بارکدهای خطی ظرفیت کم داشتند، باید دقیقاً از یک جهت اسکن میشدند و هر قطعه به چند برچسب نیاز داشت. هارا و تیمش دنبال چیزی بودند که با یک نگاه — از هر سمتی — خوانده شود.
ایده از یک بازی قدیمی آمد: صفحهی گو. مهرههای سیاه و سفید روی شبکهای منظم. همان شب، تیم شروع به طراحی کرد و نتیجه چیزی شد که امروز QR Code مینامیم: Quick Response — «پاسخ سریع» — چون قرار بود در کسری از ثانیه خوانده شود.
عددها مقیاس تصمیم را نشان میدهند: بارکد استاندارد فروشگاه ۱۳ رقم جا میدهد؛ بزرگترین نسخهی QR تا ۷٬۰۸۹ رقم — بیش از پانصد برابر. و ۴۰ نسخهی اندازه دارد، از ۲۱×۲۱ خانه تا ۱۷۷×۱۷۷، که همه از یک قاعدهی واحد پیروی میکنند: هرچه نسخه بزرگتر، خانههای بیشتری برای داده.
اما شاید مهمترین تصمیم، تصمیمی بود که به کد ربطی نداشت: Denso حق امتیازِ استفاده از استاندارد منتشرشده را آزاد گذاشت. همین تصمیم اداری بود که اجازه داد QR بدون گرفتن حقالامتیاز، از کارخانهی تویوتا به منوی رستوران سر کوچه برسد.
# نقشهی کامل: هر چیز، جای خودش
حالا که میدانیم چرا QR وجود دارد، بگذارید نقشهی کاملش را ببینیم — چون یک QR واقعی چیزهای بیشتری از سه مربع و داده دارد، و هر تکهاش یک وظیفهی مشخص:
| تکه | جای آن | کارش |
|---|---|---|
| ناحیهی ساکت | حاشیهی سفید دور کل کد | جداسازی کد از زمینهی پشتش — ۴ خانهی خالی در هر طرف |
| الگوی یابنده ×۳ | سه گوشه | پیدا کردن، جهت، مقیاس — موضوع همین مقاله |
| جداکننده | حلقهی سفید دور هر مربع | نگذارد مربعها با داده قاطی شوند |
| خطکش (Timing) | ردیف و ستون ششم، نقطهچین | یکدرمیانِ سیاهسفید؛ «هر خانه در عکس چند پیکسل است» را پلهپله نشان میدهد |
| الگوی همترازی | نزدیک گوشهی خالی (فقط نسخههای بزرگ) | جبران اعوجاج لنز و خمشدن سطح |
| نوار فرمت | کنار مربعها | سطح تصحیح خطا و ماسک انتخابشده |
| داده + تصحیح خطا | بقیهی کد | همان چیزی که ما «محتوا» مینامیم |
مربع چهارم کجاست؟ آن گوشهی خالی که گفتم، واقعاً خالی نیست — دقیقتر بگوییم: مربع بزرگ ندارد. در نسخههای بزرگتر QR، نزدیک همان گوشه یک مربع کوچکتر (الگوی همترازی) نشسته که اعوجاج عکس را جبران میکند؛ عمداً هم کوچک است تا با مربعهای اصلی اشتباه نشود. اما در کوچکترین نسخه (۲۱×۲۱) حتی آن هم نیست — چون با سه مربع، کارِ پیدا کردن و جهت گرفتن تمام است.
# چرا سهتا و نه چهار؟
حالا به سؤال تیتر میرسیم: چرا دقیقاً سه مربع؟ سه مربعای که فقط در سه گوشهاند و گوشهی چهارم عمداً بدون مربع است؟
با دو مربع چه میشد؟ موقعیت و اندازه درمیآمد — فاصلهی دو نقطه به اسکنر میگفت هر خانه چند پیکسل است. ولی دو ابهام میماند: آینهای بودن و چرخش. کد نمیفهمید کدام سمت «بالا»ست؛ و برعکسخواندن بیتها یعنی تولید دادهی بیمعنی.
با چهار مربع چه میشد؟ اینجا جایی است که شهود ما خطا میکند. چهار مربع در چهار گوشه، کد را کاملاً متقارن میکند: چرخشِ ۹۰ درجه، دقیقاً همان عکس قبلی است. اسکنر دیگر هیچ راهی برای تشخیص «کدام سطر، سطر اول است» ندارد. متقارنی، دشمنِ خواندن است.
و با سه مربع؟ سه مربع شکل L میسازند — و L متقارن نیست. گوشهی خالی خودش یک علامت است: هر گوشهای که مربع بزرگ ندارد، پایین-راست است. دیگر نه ابهام آینهای میماند، نه ابهام چرخش.
یک نکتهی هندسی هم هست: وقتی اسکنر مختصات آن سه گوشه را در عکس دارد و میداند کد مربع است، محل گوشهی چهارم را حساب میکند — حتی اگر در عکس دیده نشود. با همین سه نقطه، اسکنر میتواند کجبودن عکس (پرسپکتیو) را جبران کند و QR موربِ کج روی ویترین را در ذهنش «تخت» کند و بخواند.
پس عدد ۳ دقیقاً حداقلِ کافی است: نه کمتر (ابهام میماند)، نه بیشتر (تقارن میآید و فضا هدر میرود). سه مربع، حاصل جمعجبریِ نیازی است که کد دارد و متقارنیای که نباید داشته باشد.
# چرا دقیقاً این شکل؟ امضای ۱:۱:۳:۱:۱
خب، مربعها برای «کجا» لازماند — ولی چرا شکلشان اینقدر عجیب است؟ یک مربع سیاه سادهتر که نبود؟ هر الگوی یابنده ۷×۷ خانه است: هستهی سیاهِ ۳×۳ در وسط، دورش حلقهی سفید، و دور آن هم قاب سیاه. و اینجا تصمیم اصلی طراحی هست: هر خطی — افقی یا عمودی — که از وسط این شکل رد شود، همان یک نسبت را میدهد: سیاه ۱، سفید ۱، سیاه ۳، سفید ۱، سیاه ۱. یعنی ۱:۱:۳:۱:۱.
این نسبت سه ویژگی حیاتی دارد:
مستقل از اندازه است. کد را کوچک کنی یا بزرگ، نسبت عوض نمیکند؛ طول خطوط عوض میشود، نسبت نه. پس یک امضا برای همهی ۴۰ نسخه کافی است.
در طبیعت نادر است. در عکسهای معمولی بهندرت پیدایش میکنی: بافت پیراهن و موج مبل، این تناوب دقیقِ ۱-۱-۳-۱-۱ را ندارند.
تارشدن را تحمل میکند. حتی وقتی عکس آنقدر دور است که هر خانه فقط دو سه پیکسل شود، نسبت هنوز خواناست — چون تکهی وسط سه برابر بقیه است و کمی محو شدن لبهها این نسبت را بههم نمیزند.
صادقانه: شاید اتفاقی یک خط از دادهها هم همین نسبت را بدهد — کد QR نمیتواند جلوی تصادف را بگیرد. برای همین اسکنر بعد از پیدا کردن هر امضای ۱:۱:۳:۱:۱، یک چکِ دوبعدی هم میکند: آیا واقعاً یک «مربع داخل مربع» اینجا نشسته؟ نسبت، فیلتر سریع اول است؛ شکل کامل، تأیید نهایی.
# وقتی نصفش زیر فنجان است: تصحیح خطا
حالا که میدانیم اسکنر کد را «پیدا» میکند، سؤال بعدی این است: چرا با لکه هم «میخواند»؟ جواب یک الگوریتم است به اسم Reed-Solomon — همان خانوادهی ریاضی که خط وخش CD را جبران میکرد و سیگنال فضاپیمای Voyager را از میلیاردها کیلومتر سالم نگه میداشت.
ایدهی اصلیاش را با سیستم معادلات میشود فهمید: برای دو مجهول، دو معادله کافی است. ولی اگر چهار معادله بنویسی، از بین رفتن یکی (یا یکیدو تا) هیچبلایی سر جواب نمیآورد — بقیه جواب را زنده نگه میدارند. QR هم کنار دادهی اصلی، «معادلههای اضافه» ذخیره میکند؛ اسکنر با همین معادلههای اضافه، خانههای گمشده را بازسازی میکند.
هر کد هم از قبل یکی از چهار سطح تصحیح خطا را انتخاب کرده و در «نوار فرمت» اعلامش میکند:
| سطح | ظرفیت جبران | کجا استفاده میشود |
|---|---|---|
| L | ۷٪ | بیلبورد و فضای باز — بیشترین جای داده |
| M | ۱۵٪ | حالت پیشفرض بیشتر کدها |
| Q | ۲۵٪ | بلیت و رسید — کاغذی که تا میشود و مالیده میشود |
| H | ۳۰٪ | روی کارت ویزیت — جایی که لوگو وسط کد چاپ میشود |
مبادله هم روشن است: هرچه تصحیح بالاتر، جای داده کمتر. و برای اینکه خودِ داده اتفاقی شبیه الگوهای ممنوعه نشود، ۸ الگوی «ماسک» وجود دارد که داده را شطرنجی میکنند — جزئیاتی که اینجا فقط اشارهشان میکنم.
اما یادتان باشد: مربعها جزو هیچکدام از این سطوح نیستند. آنها قبل از تصحیح خطا لازماند — برای همین حاشیهی سفید، جداکننده و ناحیهی ساکت دورشان میکشند: اجازه بدهید داده لکه شود؛ اسکلت نباید.
# با Python: اول بسازیم، بعد جای اسکنر بایستیم
حرف که تمام شد، برویم سراغ کد. اول نقشهی یک کد ۲۵×۲۵ را میکشیم — فقط با سه مربع، دو خطکش نقطهچین و دادهی تصادفی. بدون هیچ کتابخانهای، فقط تا ببینیم «شبیه QR بودن» یعنی چه:
qr_map.py
# qr_map.py - draw what a scanner needs: only the three squares
import random
N = 25 # a real QR "version 2" size
g = [[0] * N for _ in range(N)] # 0 = light module, 1 = dark module
def finder(r, c):
"the 7x7 landmark: dark frame, light ring, dark core"
for i in range(7):
for j in range(7):
frame = i in (0, 6) or j in (0, 6)
core = 2 <= i <= 4 and 2 <= j <= 4
g[r + i][c + j] = 1 if frame or core else 0
for r, c in [(0, 0), (0, N - 7), (N - 7, 0)]: # three corners only
finder(r, c)
# timing patterns: dashed rulers on row 6 and column 6
for k in range(8, N - 8):
g[6][k] = 1 if k % 2 == 0 else 0
g[k][6] = 1 if k % 2 == 0 else 0
# everything else is data
random.seed(11)
for r in range(N):
for c in range(N):
near_finder = ((r < 8 and c < 8) or
(r < 8 and c >= N - 8) or
(r >= N - 8 and c < 8))
if not near_finder and r != 6 and c != 6 and random.random() < 0.45:
g[r][c] = 1
for row in g:
print(''.join('█' if v else '·' for v in row))
output.txt
# the printed grid, rendered visually
نگاهش کنید. هیچ پردازشی پشتش نیست — و با این حال بلافاصله میگوییم «این یک QR است». سه مربع در سه گوشه، نقطهچینِ ردیف و ستون ششم، و بقیه دادهی خام. همین کافی است که با یک نگاه، مربعها و خطکشها از داده جدا دیده شوند.
حالا جای اسکنر بایستیم. کد زیر همان کاری را میکند که یک اسکنر واقعی در ثانیهی اول میکند: همهی سطرها و ستونها را برای امضای ۱:۱:۳:۱:۱ میگردد، امضاهای نزدیک به هم را خوشه میکند (چون یک اتفاقِ تک، امضای واقعی نیست — مربع واقعی از شش جهت امضا میدهد)، و از گوشهی خالی جهت را قفل میکند. بعد هم آسیبرسانی: اول روی دادهها لکه میاندازیم، بعد یکی از خود مربعها را پاک میکنیم:
qr_find.py
# qr_find.py - stand where the scanner stands: find the three squares
import random
N = 25
def build():
g = [[0] * N for _ in range(N)]
def finder(r, c):
for i in range(7):
for j in range(7):
frame = i in (0, 6) or j in (0, 6)
core = 2 <= i <= 4 and 2 <= j <= 4
g[r + i][c + j] = 1 if frame or core else 0
for r, c in [(0, 0), (0, N - 7), (N - 7, 0)]:
finder(r, c)
for k in range(8, N - 8):
g[6][k] = 1 if k % 2 == 0 else 0
g[k][6] = 1 if k % 2 == 0 else 0
random.seed(11)
for r in range(N):
for c in range(N):
near_finder = ((r < 8 and c < 8) or
(r < 8 and c >= N - 8) or
(r >= N - 8 and c < 8))
if not near_finder and r != 6 and c != 6 and random.random() < 0.45:
g[r][c] = 1
return g
def signature(cells):
"run lengths of a 7-cell line: the finder's fingerprint is 1:1:3:1:1"
runs, cur, n = [], cells[0], 1
for v in cells[1:]:
if v == cur:
n += 1
else:
runs.append(n)
cur, n = v, 1
runs.append(n)
return runs
def find_finders(g):
hits = [] # (row, col) of signature hits
for r in range(N): # horizontal sweep
for c in range(N - 6):
win = g[r][c:c + 7]
if win[0] == 1 and signature(win) == [1, 1, 3, 1, 1]:
hits.append((r, c + 3))
for c in range(N): # vertical sweep
for r in range(N - 6):
win = [g[r + k][c] for k in range(7)]
if win[0] == 1 and signature(win) == [1, 1, 3, 1, 1]:
hits.append((r + 3, c))
clusters = [] # group nearby hits
for h in sorted(hits):
for cl in clusters:
if abs(h[0] - cl[0][0]) <= 1 and abs(h[1] - cl[0][1]) <= 1:
cl.append(h)
break
else:
clusters.append([h])
solid = [cl for cl in clusters if len(cl) >= 4] # one hit = coincidence
return [tuple(round(sum(p[i] for p in cl) / len(cl)) for i in range(2))
for cl in solid]
g = build()
first = next((r, c) for r in range(N) for c in range(N - 6)
if g[r][c] == 1 and signature(g[r][c:c + 7]) == [1, 1, 3, 1, 1])
print(f"signature found at row {first[0]}: "
f"{' '.join(map(str, signature(g[first[0]][first[1]:first[1]+7])))}")
squares = find_finders(g)
print(f"squares found: {len(squares)}")
for r, c in sorted(squares):
print(f" corner center at (row {r}, col {c})")
empty = {(3, 3), (3, N - 4), (N - 4, 3)} - set(squares)
if len(squares) == 3:
print("missing corner: the one WITHOUT a square -> orientation locked")
# damage test: scribble on random data cells
random.seed(99)
scratched = 0
while scratched < 30:
r, c = random.randrange(N), random.randrange(N)
if (r, c) not in {(3, 3), (3, N - 4), (N - 4, 3)}:
g[r][c] ^= 1
scratched += 1
after = find_finders(g)
print(f"after scratching 30 data cells: squares found = {len(after)}")
# worse: erase one landmark completely
for i in range(7):
for j in range(7):
g[i][j] = 0
lost = find_finders(g)
print(f"after erasing the top-left square: squares found = {len(lost)}")
output.txt
signature found at row 2: 1 1 3 1 1
squares found: 3
corner center at (row 3, col 3)
corner center at (row 3, col 21)
corner center at (row 21, col 3)
missing corner: the one WITHOUT a square -> orientation locked
after scratching 30 data cells: squares found = 3
after erasing the top-left square: squares found = 2
خروجی را خطبهخط بخوانید — کل مقاله در شش خط جمع شده. امضا پیدا شد؛ سه مربع در سه گوشه؛ گوشهی خالی جهت را قفل کرد. سی لکه روی داده؟ مربعها سر جایشاناند — یعنی اسکنر هنوز میداند از کجا شروع کند و کد خواندنی است. اما یک مربع که پاک شد، فقط دو امضا میماند — و دو امضای قطری، نه مقیاس مطمئن میدهند نه جهت — اسکنر جایی برای شروع ندارد.
دقیقاً به همین دلیل است که لکهی قهوه روی وسط منوی رستوران بیضرر است، ولی یک چسبزخم روی گوشهی کد، کد را بیاستفاده میکند.
# آزمایشگاه: خودت اسکنر باش
حالا نوبت شماست. کد ۲۵×۲۵ همینجا در مرورگر کشیده میشود و خط اسکن، دنبال امضای ۱:۱:۳:۱:۱ میگردد. کد را بچرخانید، لکه بیندازید، یا یکی از مربعها را پاک کنید — و ببینید اسکنر در هر حالت چه چیزی میفهمد و چه چیزی را از دست میدهد:
qr_lab.exe — interactive
کد ۲۵×۲۵ همینجا با Canvas کشیده میشود — همان منطق اسکریپت Python مقاله.
دکمه را بزن…
در دنیای واقعی، کد همیشه روبهروی شماست؟ نه. اسکنر با همان سه مربع، هندسهی کجشدن عکس را درمیآورد و کد را در ذهنش صاف میکند — پیش از اینکه حتی یک بیت بخواند. در آزمایشگاه هم بعد از هر اسکن موفق، کد بهسمت درستش صاف میشود؛ همان کاری که اسکنر با پرسپکتیو میکند.
# و بعد، سه مربع همهجا رفتند
از استیکر پرداخت ویترین فروشگاهها تا بلیت هواپیما، منوی رستوران، کارت واکسن و آدرس کیف پول بیتکوین، همهی این کدها با یک ترتیب واحد کار میکنند: اول مربعها پیدا و جهت گرفته میشوند، بعد داده خوانده میشود. این ترتیب از یک تصمیم طراحی در ۱۹۹۴ آمده — بهجای چهار مربع متقارن، سه مربع که گوشهی خالیشان جهت را نشان میدهد — و میلیاردها اسکن در روز هنوز با همان تصمیم کار میکنند.
و یک نکته که از QR بزرگتر است: سیستمهای مقاوم یک بخش کوچک و ثابت دارند — تکههایی که عمداً ساده و بدون تغییر نگه داشته میشوند، تا همهی بقیه اجازه داشته باشند انعطافپذیر باشند. در QR همین دوگانگی را میبینیم: داده با ۳۰ درصد خطا هم زنده میماند، اما مربعها با یک لکه از کار میافتند — و برای همین هیچکدام از سطوح تصحیح خطا شاملشان نمیشود. تفاوت این دو، همان تصمیم اصلی مهندسی است: اینکه چه چیزی نباید بشکند.
takeaway.txt
هر اسکن، از سه مربع شروع میشود.